皆さんこんにちは。OpenShift Virtualization とストレージを生業にしている Red Hat のうつぼ(宇都宮)です。
【NetApp コラボ特集】Virt 屋のひとりごと : 第3回は性能設計です。前回の記事では ontap-nas と ontap-san で VM のデータディスクを作成したときの容量消費の違いを比較しましたが、今回はさらに踏み込んで、同じディスクに同じワークロードをかけたとき IO パフォーマンスにどれだけ差が出るのかを fio ベンチマークで測定します。
| 回 | テーマ |
|---|---|
| 第1回 | ストレージ基本設計、Trident のドライバ選定 |
| 第2回 | 容量設計 |
| 第3回(本記事) | 性能設計 |
| 第4回 | VM 移行(Shift Toolkit) |
| 第5回 | マルチテナント設計 |
| 第6回 | データ保護 |
| 第7回 | DR 設計 |
| 第8回 | 監視と運用 |
- VMware 管理者のみなさんへ
- 測定結果についてのお断り
- 検証環境
- 測定手法の改善点
- 性能検証 1 : ブロックサイズ
- 性能検証 2 : 並列度(iodepth)
- 性能検証 3 : 複数 VM 並列
- まとめと選定ガイド
- おまけ : ベンチマーク中に起きたトラブル
VMware 管理者のみなさんへ
VMware 環境では、NFS データストアと VMFS(iSCSI / FC)データストアの性能差を気にしていた管理者は多いと思います。「NFS は手軽だけど性能は VMFS に劣る」「VMFS は速いけど管理が手間」といった議論は、VMware の世界では定番の話題でした。
OpenShift Virtualization + ONTAP でも同じ疑問があります。NFS ベースの ontap-nas と iSCSI ベースの ontap-san で、VM のディスク性能にどれくらい差が出るのか。VMware のときと同じような傾向なのか、それとも Kubernetes ならではの違いがあるのか。今回はこの疑問に fio ベンチマークで答えます。
測定結果についてのお断り
本記事の測定結果は、特定の 1 構成(AFF C190 HA ペア、10GbE x 4、SSD 12 本)で、1 VM または少数 VM から fio を実行した結果です。ストレージのモデル、ディスク構成、ネットワーク帯域、VM 数が変われば結果も変わります。ontap-nas と ontap-san の相対的な傾向を掴むための参考値として読んでください。「NFS は遅い」「iSCSI が速い」という一般論を導くものではありません。
なお、QoS による性能管理については第5回(マルチテナント設計)で、性能の監視方法については第8回(監視と運用)で詳しく扱います。
検証環境
この記事を作る上で、お借りした NetApp 機器を OpenShift クラスタに接続した検証環境を構築して動作を確認しました。以下には環境情報を記載します。
NetApp 機器および Trident
| 項目 | 値 |
|---|---|
| ストレージモデル | NetApp AFF C190 x 2(HA ペア) |
| ONTAP バージョン | 9.18.1P2 |
| Trident バージョン | 26.02 |
| ディスク | SSD x 12 本(モデル: X382_S1643960ATE / 894.3GB) |
| パーティショニング | ADP(Advanced Disk Partitioning)有効 |
| データアグリゲート | RAID-DP x 2(各ノード 1 つ)。各アグリゲートは 12 本全ディスクのデータパーティション(10 data + 2 parity)で構成 |
| アグリゲート容量 | 約 3.65TB / ノード(パーティションあたり Usable 415.8GB) |
| SVM | svm-openshift(両ノードのアグリゲートを使用) |
| ネットワーク | 10GbE x 4(iSCSI / NFS 共通) |
AFF C190 はエントリークラスの All-Flash モデルです。12 本の物理 SSD は ADP により root パーティションとデータパーティションに分割され、各ノードの root アグリゲート(aggr0)とデータアグリゲートの両方にパーティションを提供しています。SVM svm-openshift は両ノードのデータアグリゲート(sr_c190rj_01_SSD_1, sr_c190rj_02_SSD_1)を使用しています。
平たく言えば、どちらのデータアグリゲートで作られた FlexVol でも、データは 12 本すべての SSD に stripe されます。つまり ontap-san と ontap-nas のどちらの FlexVol がどちらのノードに載っていても、バックエンドのディスク IO 性能は同条件となります。
OpenShift クラスタ
| 項目 | 値 |
|---|---|
| OpenShift バージョン | 4.22.0 |
| OpenShift Virtualization バージョン | 4.22.2 |
| Control Plane Node | 3 x 仮想マシン(8vCPU, 24Gi RAM) |
| Compute Node | 3 x ベアメタルマシン(8c/16t CPU, 64Gi RAM) |
| ネットワーク | ネットワーク接続は以下(All 10GbE, MTU=9000) |
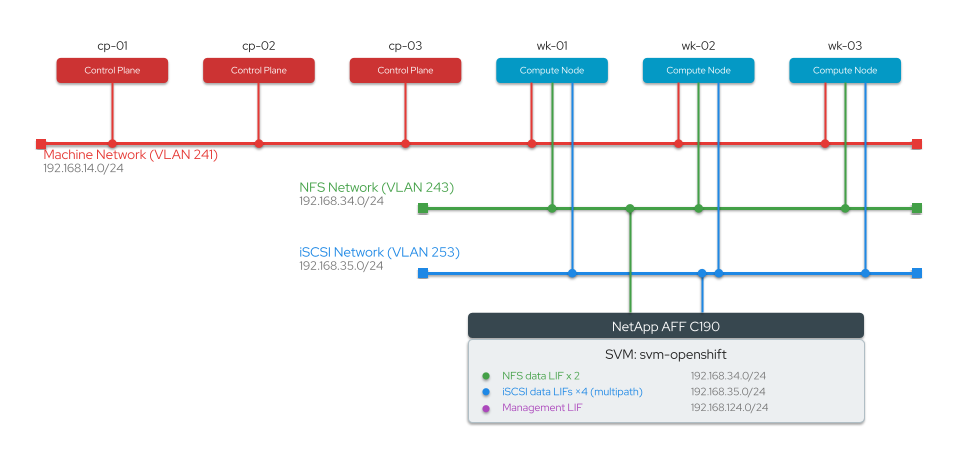
Trident の設定
ontap-san の TBC(抜粋):
defaults:
  snapshotPolicy: default
  snapshotReserve: "10"
  spaceReserve: volume
  spaceAllocation: "true"
ontap-nas の TBC(抜粋):
defaults:
  snapshotPolicy: default
  snapshotReserve: "10"
  spaceReserve: volume
  provisioningType: thin
  nfsMountOptions: nconnect=8
ontap-nas の TBC に nfsMountOptions: nconnect=8 を追加しています。VMware 環境でも NFS データストアのマウントオプションチューニング(TCP ウィンドウサイズの調整など)は行われていましたが、nconnect は Linux カーネルの NFS クライアント機能であり、Kubernetes / Trident 環境で TBC の nfsMountOptions に 1 行追加するだけで有効化できるのが特徴です。効果の詳細は次のセクションで説明します。
VM の設定
| rhel10-ontap-san | rhel10-ontap-nas | |
|---|---|---|
| OS | RHEL 10 | RHEL 10 |
| rootdisk (30Gi) | ontap-san |
ontap-san |
| datadisk (500Gi) | ontap-san |
ontap-nas |
volumeMode |
Block |
Filesystem |
| プロトコル | iSCSI | NFS(NFSv4.2) |
NFS マウントオプションの詳細
ontap-nas の NFS マウントオプションは、ontap-nas の PVC を仮想ディスクとして使用している VM が稼働する Compute Node 上で以下のコマンドにより確認できます。
$ oc debug node/wk-02 -- cat /host/proc/mounts | grep nfs
192.168.34.xxx:/trident_pvc_... /host/var/lib/kubelet/pods/.../mount nfs4 rw,relatime,vers=4.2,rsize=65536,wsize=65536,namlen=255,hard,proto=tcp,nconnect=8,timeo=600,retrans=2,sec=sys,clientaddr=192.168.34.xxx,local_lock=none,addr=192.168.34.xxx 0 0
今回の検証で使用された NFS マウントオプションの主要な値は以下のとおりです。
| オプション | 値 | 説明 |
|---|---|---|
vers |
4.2 | NFS プロトコルバージョン |
rsize |
65536 (64k) | 1 回の NFS READ RPC で転送する最大バイト数 |
wsize |
65536 (64k) | 1 回の NFS WRITE RPC で転送する最大バイト数 |
nconnect |
8 | NFS マウントあたりの TCP コネクション数 |
proto |
tcp | トランスポートプロトコル |
sec |
sys | セキュリティモード(AUTH_SYS) |
hard |
(有効) | サーバー無応答時に無期限リトライ |
Trident の TBC では nfsMountOptions: nconnect=8 のみを指定しており、それ以外のオプション(vers=4.2, rsize=65536, wsize=65536, hard, sec=sys 等)は Compute Node と ONTAP のネゴシエーションで決まったデフォルト値です。
ただし、意図して特定のオプション値(例えば nfsvers=4.2 など)を使いたい場合は、ネゴシエーション任せにせず TBC の nfsMountOptions や StorageClass の mountOptions で明示的に指定しておくのが妥当です。特に rsize / wsize は NFS の性能に直接影響するパラメータであり、後述の考察でも触れます。
注意 : Trident バージョンについて
本記事(第1回〜第3回)の検証環境では Trident 26.02 を使用していますが、Trident 26.02 は OpenShift 4.22 を公式にはサポートしていません。検証の範囲では動作に影響はありませんでしたが、私の不注意をお詫び申し上げます。実際に環境を構築される際は、必ず Trident のサポートマトリクス を確認し、お使いの OpenShift バージョンに対応した Trident バージョンを使用してください。
測定手法の改善点
実はこの記事、初稿ではデフォルトの NFS 設定(nconnect なし = TCP 1 本)で測定して「ほぼ全パターンで ontap-san が有利」と結論づけていました。しかし、この条件は NFS にとってフェアとは言えませんでした。測定手法を見直して再測定を行ったところ、特に高 iodepth や複数 VM の結果に影響がありました。見直した 2 点と、NFSv4.2 に関する補足を説明します。
1. nconnect=8 の有効化
NFS はデフォルトで 1 本の TCP コネクションですべての IO を送受信します。10GbE の帯域があっても、1 本の TCP コネクションでは CPU のシングルスレッド処理がボトルネックになりやすく、NFS の並列 IO 性能が制限されます。
一方 iSCSI は、multipath を構成していなくても iSCSI initiator 内部で複数の IO を並列に発行できます。つまりデフォルト設定同士の比較は NFS にとって不利と言えます。
NFS の nconnect マウントオプションは、1 つの NFS マウントに対して複数の TCP コネクションを張るオプションです。これにより IO を複数コネクションに分散でき、NFS の並列 IO 性能が大幅に向上します。Trident では backend の nfsMountOptions に nconnect=8 と設定するだけで有効になります。
VMware の世界では、ESXi の NFS クライアント実装が独自であり、TCP コネクション数はハイパーバイザー側で制御されていました。OpenShift Virtualization では Linux カーネルの NFS クライアントがそのまま使われるため、nconnect のような Linux カーネルのマウントオプションがそのまま効きます。これは Kubernetes / Trident 環境ならではの柔軟さです。
検証 2 では nconnect=8 の NAS と nconnect なし(=1)の NAS の両方を測定し、nconnect の効果も合わせて検証しています。
2. random_generator=lfsr の使用
fio のデフォルトの乱数生成器は、同じブロックを複数回アクセスする可能性があります。ランダム IO のベンチマークで同一ブロックに再アクセスすると、ONTAP の read cache(DRAM)にヒットして実際のディスク性能よりも高い IOPS が出てしまいます。
random_generator=lfsr(Linear Feedback Shift Register)を使用すると、テストファイル内の各ブロックが正確に 1 回だけアクセスされます。これにより ONTAP の read cache への再ヒットを抑制し、ストレージの実性能をより正確に測定できます。
3. NFSv4.2 の使用
今回の検証では NFS のバージョンとして NFSv4.2 が使われています。これは Trident や ONTAP 側で明示的にバージョン指定したものではなく、Compute Node と ONTAP のネゴシエーションで自動的に決まったバージョンです。
なお、OpenShift Virtualization 自体はストレージプロトコルに制約を設けていません。Red Hat のドキュメントには、
"there are no restrictions on storage protocol (e.g. NFS, iSCSI, FC, etc.) specific to OpenShift Virtualization. The only requirement is that the RWX access mode is available to support live migration of VMs within the cluster."
と明記されており、Live migration の要件も RWX アクセスモードであって NFS バージョンではありません。NFSv3 でも NFSv4 でも ontap-nas であれば RWX を提供でき、Live migration は動作します。
ただし NFSv3 で接続する場合は、ストレージ側が NLM(Network Lock Manager / lockd)をサポートしている必要があります。Live migration 中に QEMU がディスクイメージファイルのロックを取得・解放するため、NLM が利用できないと移行に失敗します。NFSv4 ではロック機構がプロトコルに組み込まれているため NLM は不要です。なお ONTAP は NFSv3 + NLM をサポートしているので、ONTAP をバックエンドに使う場合はどちらのバージョンでも問題ありません。
性能面では、NFSv4 には NFSv3 にはない利点があります。Compound Operations により複数の操作(LOOKUP + OPEN + READ など)を 1 つの RPC にまとめて送信でき、ラウンドトリップ数が削減されます。また NFSv4.1 以降ではセッショントランキング(Session Trunking)がサポートされ、nconnect で複数コネクションを張った際の管理も効率的に行われます。NFSv3 を使う積極的な理由がなければ、NFSv4 以上でのマウントをお勧めします。
一方、NFSv4 には Grace Period という注意点があります。ONTAP コントローラの HA フェイルオーバーが発生すると、NFSv4 サーバーはクライアントがロックを再取得するための猶予期間(Grace Period、ONTAP デフォルト 45 秒)に入ります。この間 READ/WRITE は NFS4ERR_GRACE で拒否され、クライアント側では IO が一時停止します。NFSv3 にはこの仕組みがないため、フェイルオーバー時の IO 再開は NFSv3 の方が速くなります。VMware 環境でも HA フェイルオーバー時の NFS データストアの再接続は運用上の注意点でしたが、NFSv4 の Grace Period はそれと性質の異なる遅延要因です。ベンチマーク結果には影響しませんが、運用上は知っておくべきポイントです。
性能検証 1 : ブロックサイズ
まずはシンプルに、ブロックサイズを変えたときの性能差を見てみます。7 種類のブロックサイズ(4k〜256k)× 4 種類の IO パターン(Sequential / Random × Read / Write)= 合計 28 パターンを iodepth=1 で実行しました。NAS は nconnect=8 の条件です。
[global]
time_based
runtime=120
startdelay=5
ramp_time=10
direct=1
size=450G
numjobs=1
iodepth=1
ioengine=libaio
random_generator=lfsr
filename=/myvol/testfile
direct=1で OS のページキャッシュの影響を抑制、random_generator=lfsrで ONTAP read cache への再ヒットを抑制- 各パターン 120 秒間 × 3 iter、iter2-3 の平均を採用
- 1 VM ずつ実行(ONTAP 側の負荷が相互に影響しないようにするため)
iodepth=1 についての注意 : iodepth=1 は同時に未処理の IO が 1 つだけという条件です。per-IO のレイテンシの違いを比較するには適していますが、ストレージのポテンシャルをすべて引き出す条件ではありません。この条件での結果をもってストレージの製品性能や限界性能を語ることはできません。ストレージの限界性能は検証 2(iodepth を段階的に上げる検証)で測定します。
結果
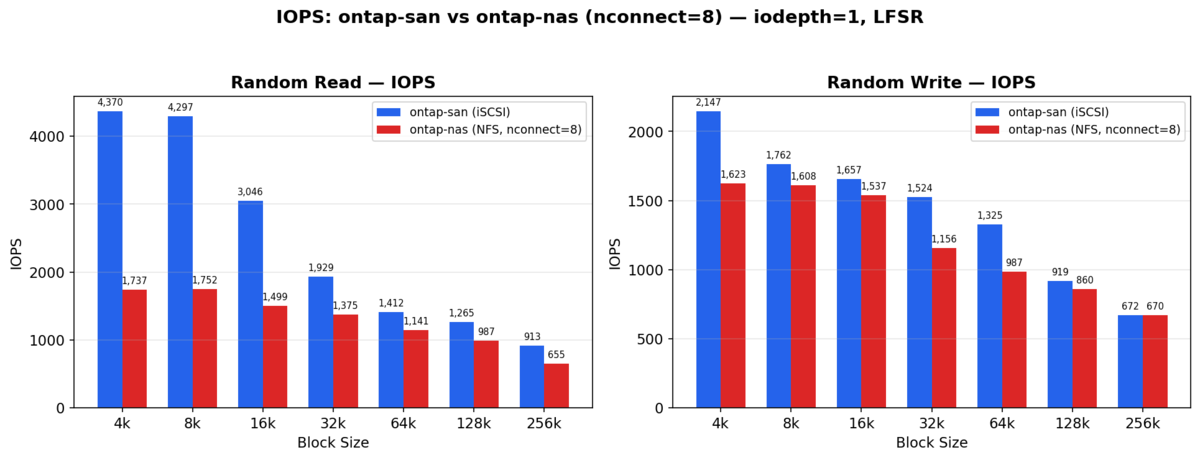
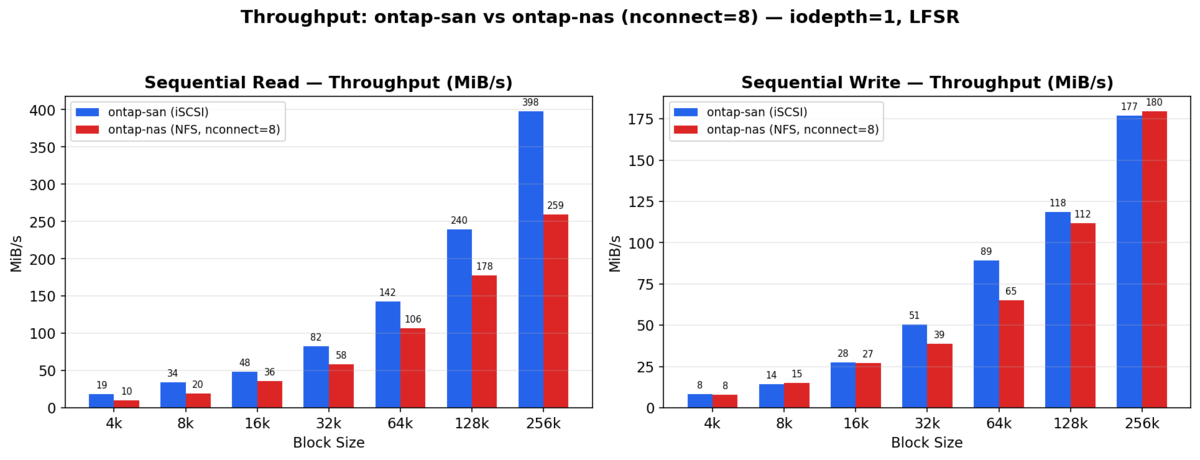
iodepth=1 の条件では、Read は全パターンで SAN が NAS を上回りました。特にブロックサイズが小さいほど差が大きく、Random Read では 4k で SAN 2.5 倍、256k で 1.4 倍です(Sequential Read: SAN 1.3〜1.9 倍)。一方 Write は SAN 優位ながらも差は小さく、Random Write で SAN 1.0〜1.3 倍、Sequential Write で SAN 0.95〜1.4 倍とばらつきがあり、ブロックサイズによっては NAS が上回るケースもありました。
nconnect=8 を設定しても iodepth=1 では同時に処理される IO が限られるため、nconnect の効果はほぼ出ていません。iodepth=1 では IO パスの短い SAN が有利で、per-IO オーバーヘッドの影響が大きい小ブロックほど差が顕著です。では iodepth を上げていくとどうなるか、次の検証 2 で見てみましょう。
性能検証 2 : 並列度(iodepth)
検証 1 は iodepth=1(同時 IO が 1 つだけ)の条件でした。しかし現実の環境では複数の VM やアプリが同時に IO を発行するのが普通です。ストレージのポテンシャルを引き出すために、iodepth を 1 → 128 まで段階的に上げて限界性能を探ります。
iodepth を上げていくと IOPS は伸びますが、やがて処理能力の限界に達して Latency が急上昇します。横軸 IOPS・縦軸 Latency でプロットするといわゆるホッケースティック型のカーブになり、実用的な動作点と限界性能が見えてきます。
テスト条件
4k Random Read / Random Write に絞り、iodepth を 1 → 128 まで段階的に上げて測定しました。SAN(iSCSI)、NAS nconnect=8、NAS nconnect=1(比較用ベースライン)の 3 構成を測定しています。
[global]
time_based
runtime=120
startdelay=5
ramp_time=10
direct=1
bs=4k
size=450G
numjobs=1
ioengine=libaio
random_generator=lfsr
filename=/myvol/testfile
iodepth: 1 / 2 / 4 / 8 / 16 / 32 / 64 / 128
各 iodepth × 各構成で 3 iter 実施し、iter2-3 の平均を採用しています(iter1 は ONTAP キャッシュウォームアップの影響があるため除外)。
再度の注意 : 以下の結果は 1 VM からの fio 実行結果です。クラスタ全体の集約性能やマルチクライアント性能を示すものではありません。複数 VM の結果は検証 3 で見ます。
結果と考察
Random Read
| iodepth | SAN (iSCSI) | NAS nc8 | NAS nc1 | SAN vs nc8 | nc8 / nc1 |
|---|---|---|---|---|---|
| 1 | 4,394 | 1,804 | 1,796 | SAN 2.4x | 1.00x |
| 2 | 10,275 | 4,072 | 4,152 | SAN 2.5x | 0.98x |
| 4 | 21,302 | 8,190 | 8,081 | SAN 2.6x | 1.01x |
| 8 | 38,704 | 15,606 | 15,152 | SAN 2.5x | 1.03x |
| 16 | 65,668 | 25,724 | 24,247 | SAN 2.6x | 1.06x |
| 32 | 106,533 | 58,893 | 36,535 | SAN 1.8x | 1.61x |
| 64 | 136,682 | 108,739 | 50,807 | SAN 1.3x | 2.14x |
| 128 | 135,911 | 121,113 | 48,758 | SAN 1.1x | 2.48x |
Random Read は、この構成では全ての iodepth で SAN が NAS nconnect=8 を上回りました。ただし、その差は iodepth が上がるにつれて縮まっています。低 iodepth(1〜16)では SAN が 2.4〜2.6 倍と大きく差をつけていますが、iodepth=64 では 1.3 倍、iodepth=128 では 1.1 倍とほぼ拮抗します。
注目すべきは nconnect=8 の効果の出方です。iodepth 1〜16 では nconnect=8 と nconnect=1 の差がほぼゼロ(nc8/nc1 ≈ 1.0x)。nconnect の効果が現れるのは iodepth=32 以降で、iodepth=128 では nc8 が nc1 の 2.48 倍に達しています。同時に発行する IO が少ないうちは複数 TCP コネクションを利用した並列化の効果が出にくいと考えられます。
Random Write
| iodepth | SAN (iSCSI) | NAS nc8 | NAS nc1 | SAN vs nc8 | nc8 / nc1 |
|---|---|---|---|---|---|
| 1 | 2,240 | 1,970 | 1,986 | SAN 1.1x | 0.99x |
| 2 | 4,628 | 3,874 | 3,545 | SAN 1.2x | 1.09x |
| 4 | 9,513 | 7,569 | 6,765 | SAN 1.3x | 1.12x |
| 8 | 16,387 | 13,556 | 12,301 | SAN 1.2x | 1.10x |
| 16 | 26,607 | 23,655 | 20,756 | SAN 1.1x | 1.14x |
| 32 | 36,975 | 34,686 | 30,471 | SAN 1.1x | 1.14x |
| 64 | 42,132 | 41,759 | 36,840 | SAN 1.0x | 1.13x |
| 128 | 42,771 | 42,824 | 37,253 | 同等 | 1.15x |
Random Write も低〜中 iodepth では SAN が優位ですが、Read ほどの大差はありません。SAN の優位は iodepth=4 の 1.3 倍が最大で、iodepth が上がるにつれて差が縮まり、iodepth=128 では NAS nconnect=8 が SAN とほぼ同等(42,824 vs 42,771 IOPS)に追いつきます。
nconnect=8 の効果は Read と同様に iodepth 依存です。低 iodepth では nc1 とほぼ同等ですが、iodepth=16 以降で nc1 の 1.14〜1.15 倍と、控えめながら一貫したプラス効果が出ています。
IOPS by iodepth
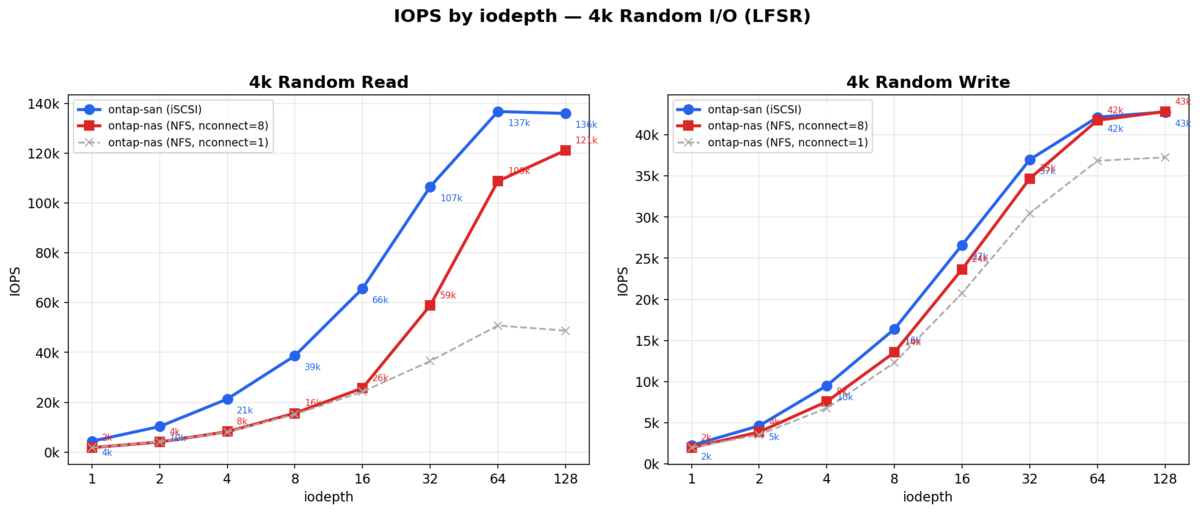
グラフにすると傾向がより明確になります。Random Read では SAN の線が終始トップを走りますが、NAS nconnect=8 の線が iodepth=32 あたりから急勾配でスケールし、高 iodepth で SAN に迫っています。NAS nconnect=1 は iodepth が上がっても伸びが鈍く、nconnect の有無で大きな差がつきます。Random Write では 3 構成とも似た軌跡を描きますが、iodepth=128 で NAS nconnect=8 が SAN に追いつくのが見て取れます。
ホッケースティックカーブ
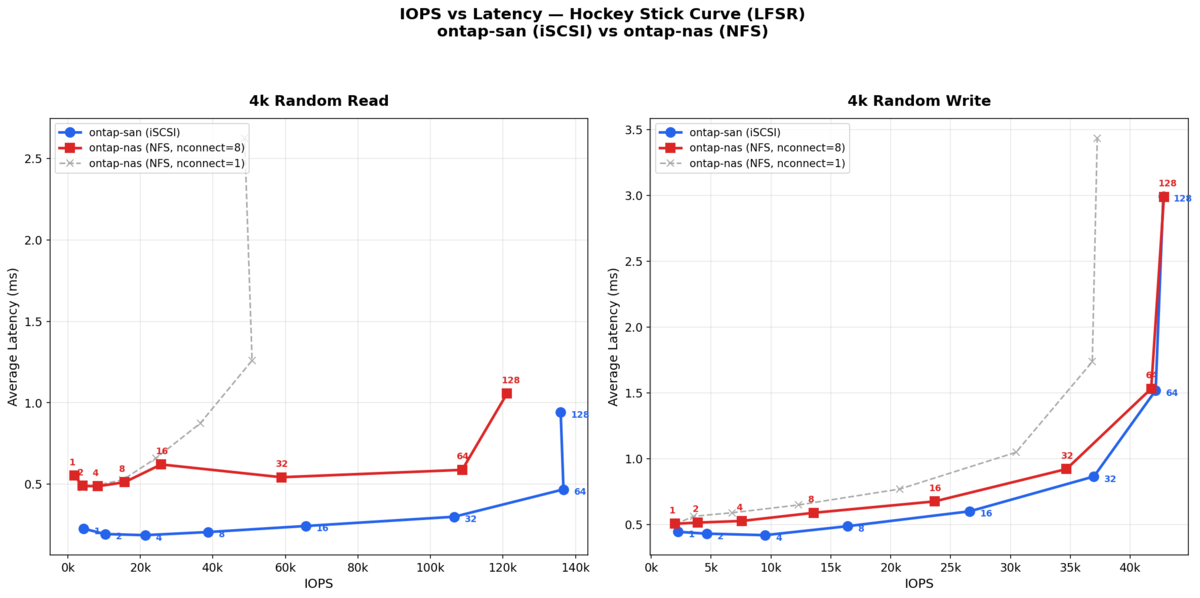
横軸を IOPS、縦軸を Latency としてプロットしたホッケースティックカーブです。
Random Read では、SAN のカーブが最も右に伸びており、137K IOPS 付近でカーブが立ち上がっています。NAS nconnect=8 は 121K IOPS まで伸びており SAN の約 89% に達していますが、Latency の上昇が SAN より早く始まっています。nconnect=1 は 51K IOPS 付近が天井です。
Random Write では、SAN が 43K IOPS に到達しても Latency の急上昇に至っておらず、まだ余力がありそうです。NAS nconnect=8 も同程度の 43K IOPS に達しており、Write に関しては SAN と NAS の天井がほぼ同じという結果です。
nconnect=8 の効果と SAN/NAS の性能差の要因に関する考察
検証 2 の結果を左右しているのは、次の 2 つの要因だと考えられます。
- IO パスの長さ : SAN を有利にする要因
- TCP コネクションの並列度 : NAS が追い上げる要因
iodepth が低いうちは要因 1 が支配的で SAN が大差をつけますが、iodepth が上がると要因 2 が効き始め、差が縮まっていきます。それぞれ見ていきましょう。
要因 1 : IO パスの長さ(SAN 有利)
ontap-san(iSCSI)の IO パス :
VM → virtio-blk → iSCSI initiator → iSCSI target → LUN → WAFL
ontap-nas(NFS)の IO パス :
VM → virtio-blk → disk image(ノード上のファイルシステム)→ NFS client → NFS server → FlexVol 内ファイル → WAFL
ontap-nas のパスには「ノード側のファイルシステム」が挟まっています。OpenShift Virtualization では、ontap-nas(volumeMode: Filesystem)の場合、VM のディスクイメージは NFS マウントされたファイルシステム上のファイルとして格納されます。VM が IO を発行するたびに、ノード側のカーネルでメタデータ処理(inode → extent map → NFS ファイルハンドル + オフセットの解決)が介在すると考えられます。
一方 ontap-san(volumeMode: Block)では、LUN がノードからブロックデバイスとして直接見えるため、ノード側にファイルシステムレイヤーが存在しません。この IO パスの短さが、SAN の per-IO レイテンシの低さにつながっている要因の一つと考えられます。
iodepth が低い(同時に飛ぶ IO が少ない)状態では、IOPS はほぼ per-IO レイテンシで決まります。IO パスが短い SAN はここで大きく有利になり、Read で 2.4〜2.6 倍の差がついています。
なお、今回の測定だけでは IO パス差と他の要因(プロトコルオーバーヘッド、NFS RPC の処理コストなど)の個別の寄与率を切り分けることはできません。上記はあくまで傾向を説明する考察です。
要因 2 : TCP コネクションの並列度(NAS 追い上げ)
nconnect=8 は NFS マウントに 8 本の TCP コネクションを張り、IO をラウンドロビンで分散します。ただし、その効果は iodepth に強く依存します。
- iodepth 1〜16: Read は nc8 ≈ nc1(nc8/nc1 ≈ 1.0x)、Write は nc8 が若干有利(1.0〜1.15x)
- iodepth 32〜128: nc8 > nc1(Read で最大 2.5x、Write で 1.1〜1.2x)
iodepth=1 では同時に未処理の IO は 1 つだけなので、TCP コネクションが 8 本あっても実際に使われるのは 1 本です。iodepth が上がって同時に複数の IO が飛ぶようになると、ようやく複数コネクションへの分散が効き始めます。
iodepth が十分に高くなると、IOPS の律速要因が per-IO レイテンシから IO の同時処理能力に移ると考えられます。こうなると、IO パスの長さによるオーバーヘッドは消えないものの、8 本の TCP コネクションによる並列性で補えるようになり、NAS が SAN との差を詰められるようになります。Read では iodepth=128 で SAN の 89%(121K vs 136K IOPS)まで追い上げ、Write では同等(43K IOPS)に追いついています。
Read での効果が Write より大きいのは、NFS の READ call が並列処理の制約が少ない操作であるのに対し、WRITE call はサーバー側で整合性処理(NVRAM への書き込み、確認応答の同期など)が介在するため、コネクションを増やしたぶんだけスケールしにくいためではないかと考えられます。
iSCSI で TCP を増やすには
iSCSI は 1 セッションあたり 1 本の TCP コネクションを使います。iSCSI の規格(RFC 7143)には MC/S(Multiple Connections per Session)という複数コネクション機能がありますが、Linux の iSCSI イニシエータ(open-iscsi)はこれをサポートしていません。iSCSI で TCP コネクションを増やすには iSCSI multipath(複数 NIC 構成)が必要です。NFS の nconnect のように Trident の TBC に nfsMountOptions: nconnect=8 と 1 行追加するだけで TCP を多重化できる手軽さは、NFS 側のアドバンテージと言えます。
性能検証 3 : 複数 VM 並列
ここまでのテストは 1 VM(1 fio プロセス)での測定です。しかし VMware 環境では 1 つのデータストアに複数の VM が載るのが当たり前でした。同様に、ONTAP 上でも複数 VM が同一の FlexVol(ontap-san の場合)や同一の NFS マウント(ontap-nas の場合)に同時にアクセスするのが現実です。VM を増やしたときに ONTAP がどこまでスケールするのか、SAN と NAS で差が出るのかを検証します。
テスト条件
3 Compute Node に VM を均等配置し、全 VM で同時に fio を実行しました。
- 3 VM: 各ノードに 1 VM ずつ(1/1/1 配置)
- 6 VM: 各ノードに 2 VM ずつ(2/2/2 配置)
fio のパラメータは検証 2 と同じですが、iodepth は 1 / 4 / 16 / 64 の 4 段階に絞っています。各 VM がそれぞれ独自の datadisk(500Gi)に対して fio を実行し、結果は全 VM の合算 IOPS です。
VMware に例えると、「1 つの ESXi ホストに 1〜2 台の VM を載せ、3 ホストクラスタ全体でストレージのスケーラビリティを見る」という構成に近いテストです。
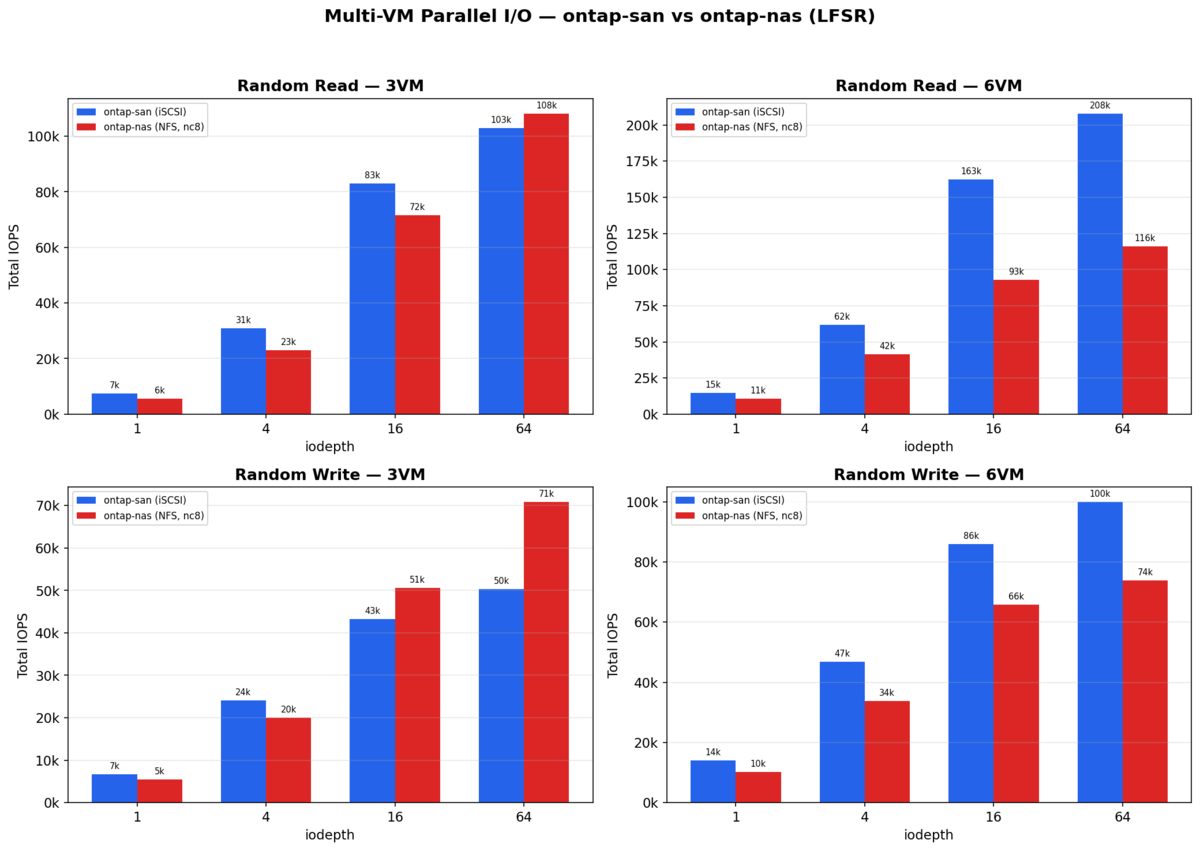
3 VM の結果
| パターン | iodepth | SAN (iSCSI) | NAS nc8 | 優位 |
|---|---|---|---|---|
| randread | 1 | 7,460 | 5,584 | SAN 1.3x |
| randread | 4 | 30,888 | 23,079 | SAN 1.3x |
| randread | 16 | 83,059 | 71,570 | SAN 1.2x |
| randread | 64 | 102,983 | 108,122 | NAS 1.05x |
| randwrite | 1 | 6,649 | 5,395 | SAN 1.2x |
| randwrite | 4 | 24,010 | 20,065 | SAN 1.2x |
| randwrite | 16 | 43,230 | 50,608 | NAS 1.2x |
| randwrite | 64 | 50,355 | 70,838 | NAS 1.4x |
3 VM では興味深い結果になりました。低い iodepth(1, 4)では SAN が 1.2〜1.3 倍で優位ですが、iodepth が高くなると NAS が逆転しています。
検証 2 の 1 VM でも、高 iodepth では NAS が SAN に迫る傾向がありました(Write iodepth=128 で同等)。3 VM ではその傾向がさらに進んでいます。3 ノードからそれぞれ nconnect=8 の TCP コネクションで IO を発行するため、ONTAP 側で並列処理できる IO の総量が増え、nconnect の効果がより強く現れていると考えられます。
6 VM の結果
| パターン | iodepth | SAN (iSCSI) | NAS nc8 | 優位 |
|---|---|---|---|---|
| randread | 1 | 14,869 | 10,707 | SAN 1.4x |
| randread | 4 | 61,645 | 41,563 | SAN 1.5x |
| randread | 16 | 162,501 | 92,993 | SAN 1.7x |
| randread | 64 | 207,877 | 115,976 | SAN 1.8x |
| randwrite | 1 | 13,986 | 10,238 | SAN 1.4x |
| randwrite | 4 | 46,829 | 33,754 | SAN 1.4x |
| randwrite | 16 | 85,962 | 65,814 | SAN 1.3x |
| randwrite | 64 | 99,924 | 73,809 | SAN 1.4x |
6 VM になると様相が一変します。全パターン・全 iodepth で SAN が優位で、その差は 1.3〜1.8 倍。3 VM で NAS が逆転していた高 iodepth 領域でも、6 VM では SAN が明確に上回っています。
SAN は iodepth=64 で randread 208K IOPS、randwrite 100K IOPS に到達。一方 NAS は randread 116K、randwrite 74K にとどまりました。
3 VM → 6 VM スケーリング
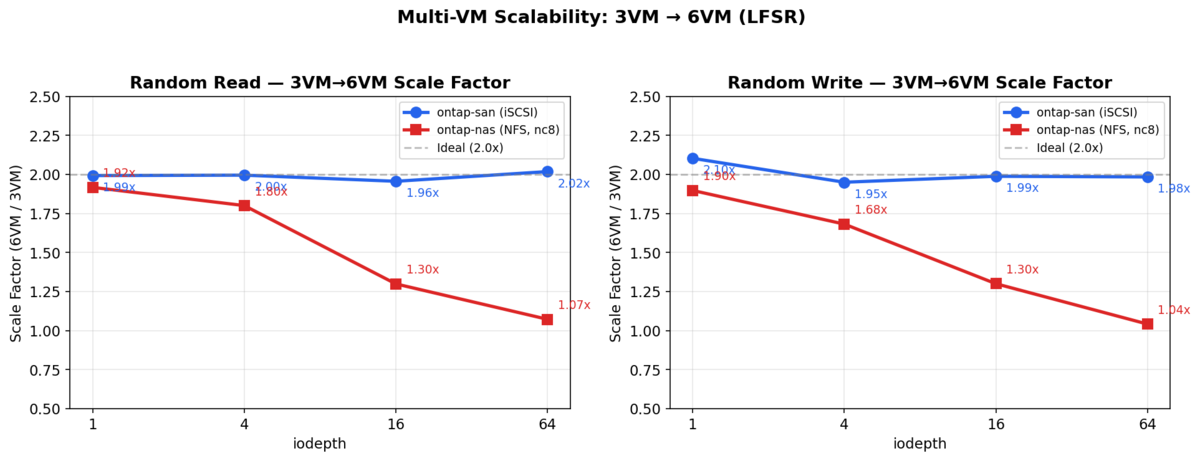
| パターン | iodepth | SAN スケール | NAS スケール |
|---|---|---|---|
| randread | 1 | 1.99x | 1.92x |
| randread | 4 | 2.00x | 1.80x |
| randread | 16 | 1.96x | 1.30x |
| randread | 64 | 2.02x | 1.07x |
| randwrite | 1 | 2.10x | 1.90x |
| randwrite | 4 | 1.95x | 1.68x |
| randwrite | 16 | 1.99x | 1.30x |
| randwrite | 64 | 1.98x | 1.04x |
ここが今回の検証で最も注目すべき結果のひとつです。
SAN は VM 数に対してほぼ理想的な線形スケーリングを示しています。3 VM → 6 VM で全パターン約 2.0 倍。ONTAP の HA ペア(2 ノード)に対して VM が均等に分散されるため、両ノードの処理能力を効率的に使い切っています。
NAS は低 iodepth では線形に近い(1.8〜1.9 倍)ものの、高 iodepth ではスケーリングが頭打ちになっています。iodepth=64 ではわずか 1.04〜1.07 倍しか伸びていません。VM を倍にしてもほとんど性能が上がらないということです。
6 VM が 3 ノードに分散し、各ノードから nconnect=8 で複数の TCP コネクションが ONTAP の NFS サーバーに集中することで、NFS プロトコルの処理(RPC の処理、コネクション管理等)がボトルネックとなり、ストレージ側が飽和していると考えられます。SAN(iSCSI)は各 LUN が独立して処理されるため、プロトコル層でのこの種のボトルネックが生じにくいと考えられます。
VMware の世界に置き換えると、「NFS データストアに多数の VM を集約すると、VMFS(iSCSI / FC)データストアに比べてスケーラビリティの壁に当たりやすい」という経験則に近い傾向です。ただし、ストレージモデルやネットワーク帯域によってその壁の位置は大きく変わります。
まとめと選定ガイド
今回は 3 種類の fio ベンチマークにより、AFF C190 上の ontap-san(iSCSI)と ontap-nas(NFSv4.2, nconnect=8)の IO 性能を比較しました。
検証結果サマリ
| 検証 | 条件 | Read | Write |
|---|---|---|---|
| 検証 1 | 1 VM, iodepth=1, BS 可変 |
SAN 1.2〜2.5x(小 BS ほど差大) | SAN 0.95〜1.4x(NAS 優位もあり) |
| 検証 2 | 1 VM, iodepth 可変, 4k | SAN 1.1〜2.6x(高 iodepth で差縮小) | SAN 1.0〜1.3x(iodepth=128 で同等) |
| 検証 3(3 VM) | 3 VM, iodepth 可変, 4k | 低 iodepth: SAN、高 iodepth: ほぼ同等 | 低 iodepth: SAN、高 iodepth: NAS 1.4x |
| 検証 3(6 VM) | 6 VM, iodepth 可変, 4k | SAN 1.4〜1.8x | SAN 1.3〜1.4x |
結果から見えたこと
1 VM では Read は SAN が安定して速い。 Write も多くの条件で SAN が優位ですが、iodepth が上がるにつれて差は縮まり、Write の iodepth=128 では NAS nconnect=8 が SAN と同等まで追いつきます。
nconnect=8 は高 iodepth で効果を発揮する。 nconnect=8 の効果は iodepth 32 以上で現れます。Read では nconnect=1 の最大 2.5 倍、Write でも 1.1〜1.2 倍の向上が得られます。逆に iodepth が低い状態では nconnect を増やしても効果はほぼありません。NFS を使うなら nconnect の設定が性能に大きく影響しますが、その効果が活きるのは IO の並列度が高い環境です。
NFS は NFSv4 以上を使う。 今回の検証では NFSv4.2 を使用しています。NFSv4 の Compound Operations によるラウンドトリップ削減やセッショントランキングは nconnect と相性が良く、NFSv3 よりも効率的に並列 IO を処理できます。
VM 数がスケールする環境では SAN にスケーラビリティの利がある。 SAN は VM 数に対して線形にスケールしますが、NAS は高 iodepth で頭打ちになる傾向が見られました(この AFF C190 構成の場合)。多数の VM が同時に高 IO を発行する環境では、SAN のスケーラビリティが光ります。
少数 VM なら NAS も十分競争力がある。 3 VM 程度であれば NAS nconnect=8 は高 iodepth で SAN と同等以上の性能を出しており、用途によっては ontap-nas が有利な場面もあります。
プロトコル選定ガイド : 性能だけでは決まらない
VMware から OpenShift Virtualization へ移行する際、ストレージプロトコルの選定は性能だけで決まるものではありません。VMware のときと同様に、総合的な判断が必要です。以下の観点で整理します。
| 観点 | ontap-nas(NFS) |
ontap-san(iSCSI) |
|---|---|---|
| IOPS 性能(1 VM) | SAN に劣るが nconnect=8 + 高 iodepth で差は縮まる |
全般的に安定して高い |
| スケーラビリティ(多 VM) | 高 iodepth で頭打ち傾向あり | VM 数に対して線形にスケール |
| Live migration | RWX を標準サポート。VMware の vMotion と同様にストレージ側の追加設定不要 | RWX(volumeMode: Block)で対応可能 |
| 運用のシンプルさ | NFS マウントのみ。VMware の NFS データストアと同様に管理がシンプル | iSCSI initiator、LUN マッピングが必要 |
nconnect によるチューニング |
TBC に 1 行追加で TCP 多重化。Kubernetes / Trident ならではの手軽さ | TCP 多重化には multipath(複数 NIC)が必要 |
| バックアップ・DR | ONTAP SnapMirror、Trident Protect で NFS / iSCSI ともに対応。プロトコル差は小さい | 同左 |
| 既存の運用ナレッジ | VMware で NFS データストアを運用していた組織には親和性が高い | VMware で VMFS + iSCSI / FC を運用していた組織には親和性が高い |
性能要件が見えている場合 : 例えばピーク IOPS が 20,000 IOPS 程度であれば、ontap-nas も ontap-san もどちらもサブミリ秒で返すので、ぶっちゃけ大差ありません。その場合は論理構成がシンプルな ontap-nas を選ぶ判断は全くもって妥当です。多数 VM の高 IOPS が必要な環境では ontap-san のスケーラビリティが活きます。
性能要件が見えていない場合 : 最近は Storage live migration も GA になって ontap-san ↔ ontap-nas の移動は簡単にできるので、まずは気楽に ontap-nas + nconnect=8 で始めて、性能要件に応じて ontap-san に切り替えるというアプローチも十分現実的です。
VMware で NFS データストアを使っていた場合 : NFS の運用ナレッジがある組織なら、ontap-nas は移行のハードルが低いです。nconnect=8 を忘れずに設定すれば、性能面でも十分戦えます。
VMware で VMFS + iSCSI / FC を使っていた場合 : SAN の運用ナレッジがある組織なら、ontap-san への移行は自然な選択です。ただし、OpenShift / Kubernetes 環境では Trident が LUN の管理を自動化してくれるため、VMware 時代の LUN 管理の手間は大幅に軽減されます。
なお、QoS による VM ごとの性能制御については第5回(マルチテナント設計)で、日常的な性能監視の方法については第8回(監視と運用)で詳しく扱います。
というわけで今日はここまで。次回の第4回では、NetApp Shift Toolkit と MTV を使った VM の移行について紹介します。
おまけ : ベンチマーク中に起きたトラブル
今回のベンチマークで、snapshotPolicy: default のまま fio を実行した結果、ONTAP の Snapshot 差分が snapshotReserve(10%)を超えて FlexVol を埋め尽くし、VM が PausedIOError で停止するというトラブルが発生しました。容量編で「snapshotReserve: 10 を設定しておけば Snapshot 領域を確保できる」と書きましたが、変更率の高いワークロードでは 10% でも不足し得るという実例です。
fio のような大量書き込みを行うワークロードでは、1 時間ごとの定期 Snapshot が取得されると、変更ブロックが Snapshot に保持され続けます。450G のファイルを繰り返し上書きすると、差分が膨張し、今回は snapshot-space-used が 195% に達しました。
Write のベンチ実施時には、対象ボリュームの snapshotPolicy を一時的に none に変更しましょう。また、既存の Snapshot も削除しておくことを強くおすすめします。WAFL の Snapshot は Redirect-on-Write で、Snapshot 作成時はほぼ無風ですが削除時にブロックの解放処理がわーっと発生して性能に影響を及ぼすので、安全のためベンチの前に消しておきましょう。
本番環境では、ワークロードの変更率(日次の変更ブロック量)と Snapshot の保持世代数から必要な snapshotReserve を見積もり、Snapshot 使用率を監視することが重要です。「10% にしておけば安心」ではなく、実際の変更パターンに合わせた設計が必要です。
