こんにちは、レッドハットでソリューションアーキテクトをしている石川です。
みなさんvLLM使っていますか?
vLLMはオープンモデルの推論を行うため、多くのユーザーや企業などで利用されているOSSです。
レッドハットは昨年のNeural Magicの買収を契機として、主要なコントリビューターの一社としてvLLMの開発を推進しています。現在では、vLLMの本体だけではなく、量子化ツールのLLM Compressor、Speculative Decodingのドラフトモデルを作成するSpeculatorsなど、様々なサブプロジェクトについても積極的に取り組んでいます。
そんなvLLMですが、利用する際に悩ましいのが起動時にどんなオプションを与えるか、です。
単にモデルを動かすということだけであれば、オプションを付けずにそのままvLLMを起動すれば良いですが、モデルごとに適切な設定を行い推論を効率化するためには沢山ある起動オプションの中から何を選んで設定するかを検討する必要があります。
突き詰めると、実行するワークロードの特性によって与えるべき設定はケースバイケースとなりますが、このブログ記事では基本的な考え方や、おすすめの設定を紹介したいと思います。
Recipes
vLLMのオプション設定を検討する上で、まず確認すべきなのがvLLMコミュニティが公開しているrecipes.vllm.aiです。
recipes.vllm.ai
ここではHugging Faceで公開されている様々なモデルに対し、vLLMのどのバージョンが対応していて、どんな設定をすべきかという情報が載っています。
利用するGPUや、モデルの量子化ごとのパターンも確認できるため、モデルの実行に関わる多くの悩みはこちらのページを見ることで解決することができます。
まずはここで実行したいモデルを検索し、モデルごとに異なる値を設定する--tool-call-parserや、--reasoning-parserなどの基本的な設定値を確認することをおすすめします。
KV Cache量子化
推論を高速に実行する上でKV Cacheは欠かすことができない存在ですが、vLLMでは--kv-cache-dtypeによりKV Cacheの量子化を設定することができます。KV Cacheはモデル本体の量子化と比較し外れ値の影響を受け易く、また一部のGPUではハードウェア側の問題によって顕著なパフォーマンスの劣化があったことから、以前は元精度(BF16)のまま取り扱うことが一般的でした。
しかしvLLMやFlash Attentionの様々な改善を通じて、現在ではパフォーマンスの劣化を抑えながらKV Cacheを量子化することが可能となりました。これにより必要なVRAM量を削減しつつ、トークンスループット向上に寄与しています。
--kv-cache-dtypeではfp8のほか、Turbo Quantなどの量子化設定をサポートしています。
しかし、以下のvLLMのコミュニティブログで検証された結果を見ると、Turbo QuantではAttention計算時の逆量子化によるオーバーヘッドの影響が大きく、それに伴うトークンスループットの低下が確認されています。
vllm.ai
そのため、まずは--kv-cache-dtypeにはfp8を設定し、要件に応じて他の値を試すのが良いでしょう。
KV CacheのCPUメモリへのオフロード
以前よりvLLMではOffloading Connectorを利用したKV CacheのCPUメモリ(DRAM)へのオフロードがサポートされていました。しかし、このOffloading Connectorが導入された当時、Attention層は全て一様であることが前提となっており、昨今のモデルで採用されている複数のAttentionタイプ(Sliding Window、Mamba、など)を併用するハイブリッドモデルでの利用がサポートされていませんでした。そのためKV Cacheオフローディングのための機能は存在するが、新しいモデルでは利用できないというジレンマが生じていました。
vLLMのv0.21.0にて、ハイブリッドモデルのメモリを管理するHMA(Hybrid Memory Allocator)がOffloading Connectorでサポートされ、以降のバージョンでは多くのモデルでKV Cacheのオフロードが利用できるようになっています。
DRAMへのオフロードは--kv-offloading-sizeにて、利用する領域をGiB単位で設定するか、--kv-transfer-configから詳細を設定することができます。後者の詳しい設定方法については以下のドキュメントを参照してください。
ドキュメントのTipsにも記載がありますが、DRAMにオフロードする容量はVRAMのKV Cache容量の総計より大きい値を設定する必要があります。
docs.vllm.ai
Speculative Decoding
Speculative Decodingとは小規模なドラフトモデルを利用して、現在から複数先のトークンを予測し、それを本来利用したいモデル(ターゲットモデル)で検証することで、出力の品質を落とさずに高速なトークン出力を可能とする推論のテクニックです。
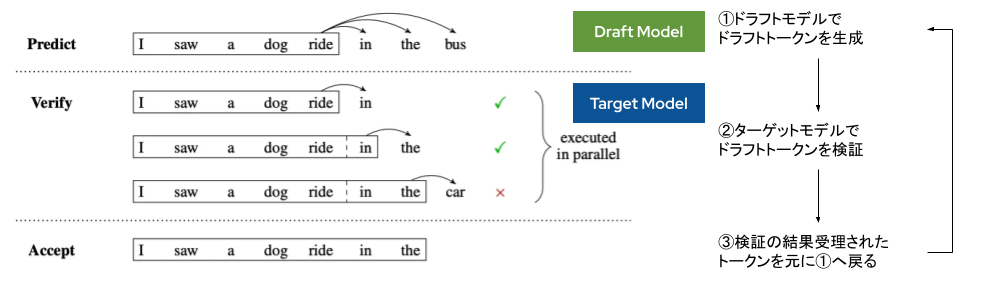
最近では、ターゲットモデルの一部としてドラフトトークン生成を可能とするMTP(Multi Token Prediction)ヘッドを備えたモデルが公開されたり、ドラフトモデルとして拡散生成モデルを利用するDFlashや、そのアイディアの発展形であるDSparkが公開されるなど、Speculative Decodingに関連した技術の進歩が進んでいます。
リクエスト数が増加しVRAMのメモリ帯域が逼迫すると逆にスループットが低下するため、推論における銀の弾丸というわけではありませんが、体感としての推論速度向上を感じやすく最近では広く利用されるようになっています。
vLLMでは--speculative-configにて設定します。
--speculative-config '{
    "method": "dflash",
    "model": "<draft/model>",
    "num_speculative_tokens": 5
  }'
ドラフトモデルについては、モデルプロバイダーが提供するものや、Red Hatが提供するもの、あるいはSpeculatorsを利用して自身でトレーニングしたモデルなどを設定できます。
番外編: Red Hat AI Repository on Hugging Face
vLLMの設定ではないですが、レッドハットはHugging Faceのリポジトリ上でさまざまなモデルを公開しています。
huggingface.co
複数の形式で量子化されたメジャーなオープンモデルや、最新のSpeculative Decodingのドラフトモデルなど、現在では700以上のモデルを公開しています。どなたでもダウンロードして利用することができるので、このブログ記事で紹介した設定と合わせ、よければお試しください。
おわりに
この記事ではvLLMのおすすめオプション設定方法について紹介しました。レッドハットではvLLMや、分散推論のOSSであるllm-dをプロダクトとして提供しており、併せてエンタープライズレベルでのサポートを提供しています。本番環境での推論環境構築にご興味あればぜひレッドハットへお問い合わせください。
